Une application qui appelle directement l’API d’un seul fournisseur de modèles hérite de ses pannes, de ses quotas et de ses prix. Quand ce fournisseur répond 503 pendant vingt minutes, le produit s’arrête. Quand un modèle sept fois moins cher sort, il faut modifier chaque client.
Nous avons déplacé ce problème dans une gateway LLM open source, agentgateway, que nous exploitons devant un SaaS. Voici ce que nous avons appris en octobre 2026 avec la version 1.6.0 : les fournisseurs gratuits qui tiennent vraiment, la façon d’organiser modèles et utilisateurs, notre configuration, et les pièges rencontrés.
Pour fixer les ordres de grandeur : 9 fournisseurs branchés, 29 modèles, 7 catégories de routage. Sur la catégorie « rapide », le coût de sortie se situe entre 0 et 0,50 USD par million de tokens selon le fournisseur qui répond, contre 4,50 USD pour le modèle « mini » d’un grand éditeur utilisé auparavant.
Fournisseurs de modèles gratuits : testés et validés
Les offres gratuites changent tous les mois : Cerebras et GitHub Models ont fermé la leur en 2026. Nous ne listons que les fournisseurs branchés sur la gateway et validés par une vraie requête le 8 octobre 2026. Vérifiez les limites dans chaque console avant de vous engager.
| Fournisseur | Modèles validés | Ce qu’il faut savoir | Usage retenu |
|---|---|---|---|
| Google AI Studio (clé gratuite) | Gemini 3.8 Flash | 503 « high demand » fréquents aux heures de pointe. Les prompts du palier gratuit peuvent servir à améliorer les produits Google, sauf projets rattachés à l’EEE, au Royaume-Uni ou à la Suisse | Production, premier choix |
| Groq | gpt-oss-20b, gpt-oss-120b | 30 req/min et 1 000 req/jour gratuits par modèle, puis 0,075 / 0,30 USD par million de tokens. Pas d’entraînement sur vos données | Production |
| Cloudflare Workers AI (plan gratuit) | Gemma 4 26B | 10 000 « neurons » par jour. Les modèles récents (GLM 5.3, DeepSeek V4, Kimi K2.7) exigent le plan Workers Paid | Production |
| NVIDIA NIM (Developer Program) | GLM 5.3, DeepSeek V4.1 Flash, Nemotron 3.5, Kimi K3 | 10 000 req/jour, latence parfois supérieure à 100 s. Réservé au prototypage sans licence NVIDIA AI Enterprise | Développement uniquement |
OpenRouter (modèles :free) |
Gemma 4, Nemotron 3 Super et Ultra, Apodex 1.1 Mini | 50 req/jour (1 000 après 10 USD de crédits). Les fournisseurs amont peuvent journaliser les prompts | Développement uniquement |
Deux leçons. « Gratuit » ne veut pas dire « utilisable en production » : les conditions de NVIDIA NIM et la journalisation possible chez OpenRouter excluent ces offres pour des données clients. Et chaque fournisseur refuse une requête à sa manière (503, 403, 429, ou une erreur dans un corps HTTP 200) : c’est exactement ce que la gateway doit absorber.
Non testés, donc non recommandés ici : Mistral, Cohere (usage non commercial seulement), Z.ai, ModelScope, SiliconFlow.
agentgateway, en deux minutes
agentgateway est un proxy open source en Rust pour le trafic IA : API compatibles OpenAI et Anthropic, serveurs MCP, modèles de décision. Un binaire ou une image Docker, un fichier YAML, une interface d’administration avec logs, coûts et clés.
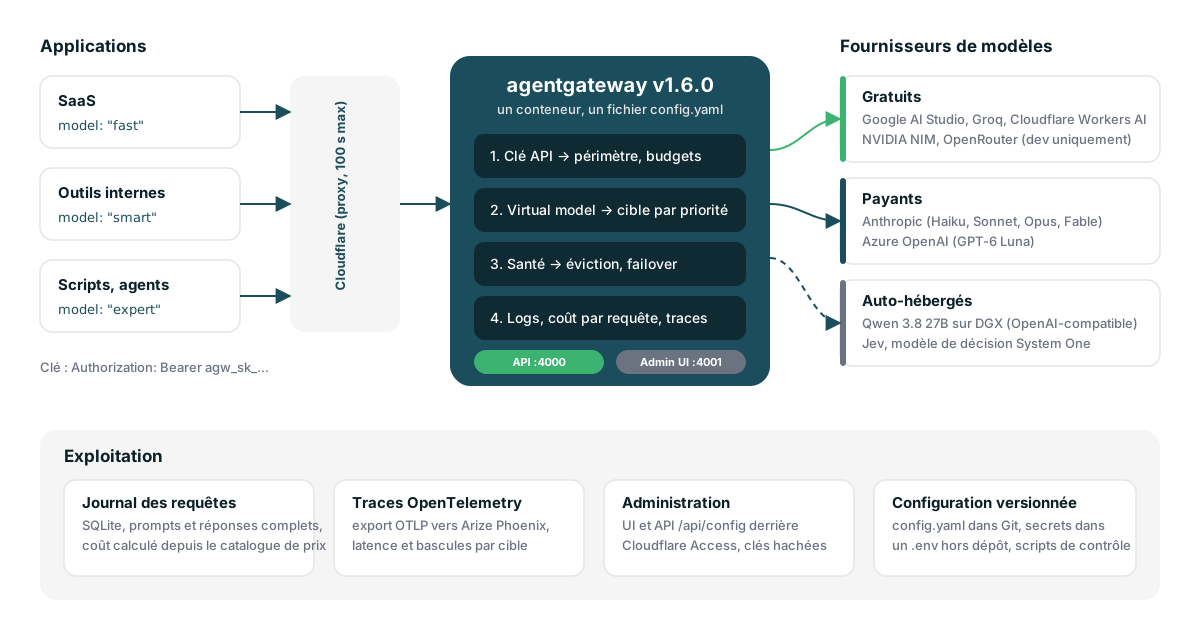
Ce qui nous a décidés :
- Les virtual models. Un client appelle
fast,smart,expertoufrontier. La gateway choisit le fournisseur réel, écarte ceux qui échouent et bascule sur le suivant. Changer de fournisseur ne touche plus au code client. - Les clés API avec périmètre et budget. Chaque client reçoit une clé stockée hachée, limitée à une liste de modèles, avec des plafonds glissants en dollars.
- Le coût par requête. Un catalogue de prix par fournisseur permet d’afficher le coût réel de chaque appel, y compris pour un modèle auto-hébergé auquel on attribue un tarif interne.
- L’observabilité. Journal des requêtes en SQLite, traces OpenTelemetry (vers Arize Phoenix chez nous), relecture d’une conversation complète dans l’UI.
Gérer les modèles : du gratuit vers le payant
Un seul principe : dans chaque catégorie, les cibles sont classées du gratuit ou auto-hébergé vers le plus cher, et la gateway ne monte dans la liste que si la cible précédente est écartée.
| Catégorie | Cibles, par priorité croissante | Usage |
|---|---|---|
fast |
Gemini 3.8 Flash → Groq gpt-oss-20b → Cloudflare Gemma 4 → GPT-6 Luna → Claude Haiku 5.5 | Classification, extraction, réponses courtes |
smart |
Qwen 3.8 27B auto-hébergé → Groq gpt-oss-120b → Claude Sonnet 5.5 | Rédaction, raisonnement courant |
expert |
Claude Opus 5.5 | Tâches longues et complexes |
frontier |
Claude Fable 5.1 | Qualité maximale |
dev-* |
NVIDIA NIM et OpenRouter gratuits | Développement, fermé aux clés clients |
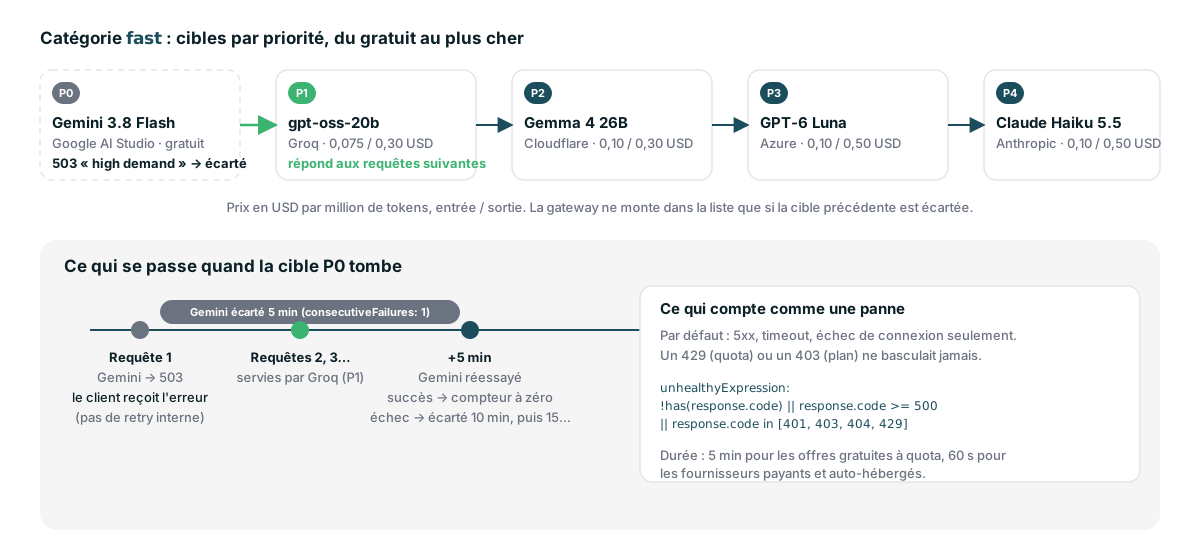
Deux réglages font toute la différence. D’abord, ce qui compte comme une panne : par défaut, agentgateway n’écarte une cible que sur une erreur 5xx ou un timeout. Un quota dépassé (429) ou un modèle refusé par le plan (403) ne déclenchait aucun basculement ; nous l’avons constaté sur cinq requêtes consécutives. Chaque modèle porte désormais une expression qui élargit la règle :
health:
  unhealthyExpression: '!has(response.code) || response.code >= 500 || response.code in [401, 403, 404, 429]'
  eviction:
    consecutiveFailures: 1
    duration: 5m
Ensuite, la durée d’éviction : agentgateway la multiplie à chaque échec consécutif (5, 10, 15 minutes) et remet le compteur à zéro au premier succès. Cinq minutes pour les offres gratuites à quota, soixante secondes pour les fournisseurs payants dont les pannes sont passagères.
Une limite à connaître : la requête qui tombe sur une cible en panne reçoit l’erreur, ce sont les suivantes qui basculent. Vos applications gardent donc un retry côté client, au moins sur 429 et 5xx.
Gérer les utilisateurs : une clé par client
Chaque client ou équipe reçoit une clé dont seul le hash SHA-256 figure dans la configuration. La valeur en clair est remise une seule fois et conservée hors du dépôt Git. Trois leviers par clé : allowedModels (les catégories autorisées), budgets (plafonds glissants en USD, blocage ou simple audit au dépassement) et metadata (un nom pour les logs).
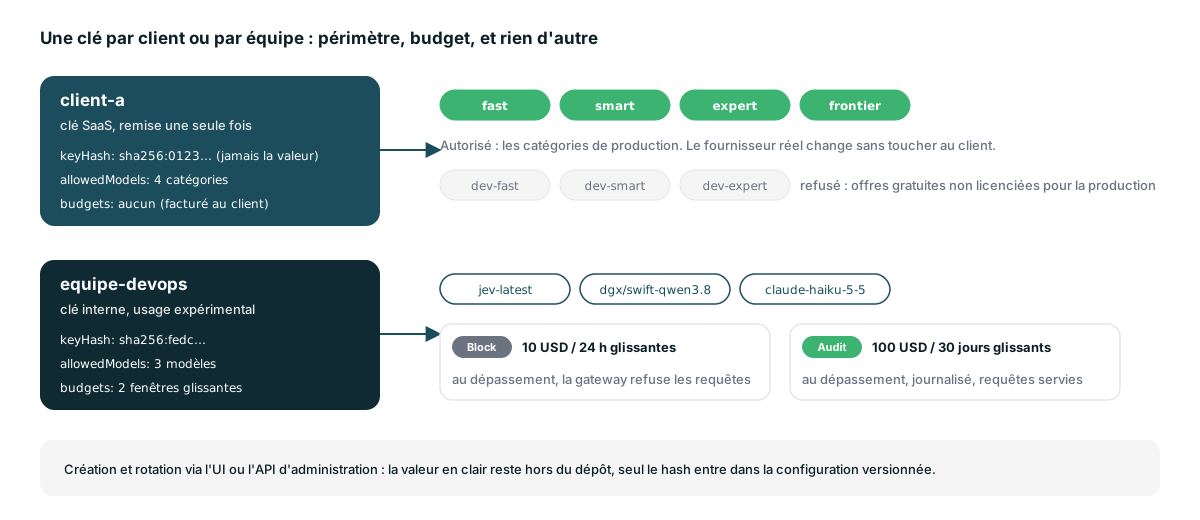
La création et la rotation se font dans l’interface d’administration, ou par son API (PUT /api/config/resources/llm.apiKey), qui réécrit le fichier de configuration sur le serveur. Si la configuration est versionnée, ce fichier doit être commité juste après.
La configuration, en pratique
Le déploiement tient en un compose.yaml. Les secrets vivent dans un fichier d’environnement hors dépôt ; la configuration et le catalogue de prix sont montés depuis le dépôt.
services:
  agentgateway:
    image: cr.agentgateway.dev/agentgateway:v1.6.0
    container_name: agentgateway
    restart: unless-stopped
    user: "1000:1000"
    ports:
      - "127.0.0.1:4000:4000"   # API LLM, exposée via Cloudflare
      - "127.0.0.1:4001:4001"   # UI et API d'administration, derrière Cloudflare Access
    env_file: "/data/agent_gateway.env"
    volumes:
      - /data/agentgateway:/data
      - ./config/:/config
La configuration ci-dessous est la nôtre, anonymisée et réduite à l’essentiel : un bloc health identique sur chaque modèle (montré une fois), quelques modèles par fournisseur, deux catégories, deux clés.
# yaml-language-server: $schema=https://agentgateway.dev/schema/config
config:
  database:
    url: sqlite:///data/data.db
  modelCatalog:
  - file: /config/base-costs.json      # catalogue de prix fourni par agentgateway
  - file: /config/extra-costs.json     # prix manquants et tarifs internes

gateways:
  default:
    listeners:
    - name: api
      hostname: api.example.com
    port: 4000
  ui-gateway:
    port: 4001

ui:
  gateways:
  - ui-gateway

llm:
  gateways:
  - default

  models:
  - name: free/gemini-3.8-flash
    provider:
      reference: free-gemini
    health:
      unhealthyExpression: '!has(response.code) || response.code >= 500 || response.code in [401, 403, 404, 429]'
      eviction:
        consecutiveFailures: 1
        duration: 5m
    transformation:
      model: llmRequest.model.stripPrefix("free/")
  - name: groq/gpt-oss-20b
    provider:
      reference: groq
    health: ...                                  # même bloc, duration 5m
    params:
      model: openai/gpt-oss-20b
  - name: cf/gemma-4-26b
    provider:
      reference: cloudflare-ai
    health: ...
    params:
      model: '@cf/google/gemma-4-26b-a4b-it'     # les identifiants commençant par @ se mettent entre guillemets
  - name: claude-haiku-5-5
    provider:
      reference: anthropic
    health: ...                                  # même bloc, duration 60s
  - name: claude-sonnet-5-5
    provider:
      reference: anthropic
    health: ...
  - name: dgx/swift-qwen3.8                      # modèle auto-hébergé, serveur OpenAI-compatible
    provider:
      reference: dgx
    health: ...
    params:
      model: ukisai/Swift-Qwen3.8-27B-NVFP4

  providers:
  - name: free-gemini
    provider: gemini
    params:
      apiKey: $GOOGLE_KEY
  - name: groq
    provider:
      custom:
        providerOverride: groq        # le preset sert à retrouver les prix dans le catalogue
        formats:
        - type: completions           # obligatoire en v1.6.0, non hérité du preset
    params:
      baseUrl: https://api.groq.com/openai/v1   # obligatoire aussi
      apiKey: $GROQ_KEY
  - name: cloudflare-ai
    provider: openai
    params:
      baseUrl: https://api.cloudflare.com/client/v4/accounts/ACCOUNT_ID/ai/v1
      apiKey: $CLOUDFLARE_AI_KEY
  - name: anthropic
    provider: anthropic
    params:
      apiKey: $ANTHROPIC_KEY
  - name: dgx
    provider: openai
    params:
      baseUrl: http://dgx.internal:8000/v1
      apiKey: no-key

  virtualModels:
  - name: fast
    routing:
      failover:
        targets:
        - model: free/gemini-3.8-flash      # gratuit
          priority: 0
        - model: groq/gpt-oss-20b           # 0.075 / 0.30 USD par million de tokens
          priority: 1
        - model: cf/gemma-4-26b             # 0.10 / 0.30 USD
          priority: 2
        - model: claude-haiku-5-5           # 0.10 / 0.50 USD
          priority: 3
  - name: smart
    routing:
      failover:
        targets:
        - model: dgx/swift-qwen3.8          # auto-hébergé
          priority: 0
        - model: claude-sonnet-5-5          # 2 / 10 USD
          priority: 1

  policies:
    apiKey:
      mode: strict
      location:
        header:
          name: authorization
          prefix: 'Bearer '
      keys:
      - metadata:
          name: client-a
        allowedModels:
          - fast
          - smart
        keyHash: sha256:0123456789abcdef...   # seul le hash est stocké
      - metadata:
          name: equipe-devops
        allowedModels:
          - dgx/swift-qwen3.8
          - claude-haiku-5-5
        budgets:
        - name: daily-spend
          limit:
            unit: USD
            amount: 10
          window:
            rolling: 1d
          onBudgetExceeded: Block
        - name: monthly-spend
          limit:
            unit: USD
            amount: 100
          window:
            rolling: 30d
          onBudgetExceeded: Audit
        keyHash: sha256:fedcba9876543210...

frontendPolicies:
  accessLog:
    database:
      llm: full
  tracing:
    host: 172.17.0.1:4317      # collecteur OpenTelemetry
    randomSampling: true
Côté client, rien ne change par rapport à un appel OpenAI classique, seul le nom du modèle devient une catégorie :
curl -sS "https://api.example.com/v1/chat/completions" \
  -H "Authorization: Bearer agw_sk_..." \
  -H "Content-Type: application/json" \
  -d '{"model": "fast", "messages": [{"role": "user", "content": "Classe ce ticket : facturation, livraison ou technique ?"}]}'
Le champ model de la réponse indique le modèle qui a réellement répondu : c’est ainsi qu’on observe les bascules.
Les pièges de la v1.6.0
Chacun de ces points nous a coûté une interruption avant d’être compris :
- Tout le fichier de configuration passe par une expansion de variables d’environnement, commentaires compris. Un commentaire
# $0.10a été lu comme la variable0, et la gateway a refusé de démarrer. Pas de$hors références à des variables. - Les providers « custom » nommés exigent
baseUrletformats, même avec un preset. Sinon : refus au démarrage, puisunsupported conversionà la première requête. - Les 4xx ne déclenchent pas le failover par défaut. Voir
unhealthyExpressionplus haut. - Les API en passthrough (modèles de décision System One) ne se routent pas par virtual model : le corps est transmis tel quel, nom de catégorie compris.
- Cloudflare coupe les requêtes non streamées à 100 secondes. Streaming obligatoire pour les catégories
expertetfrontier.
Rien de rédhibitoire : ce sont des comportements visibles dans le code plus que dans la documentation, le prix d’un projet jeune qui sort une version mineure par mois.
Ce que nous recommandons
- Classer par coût dans les catégories courantes, par qualité dans une catégorie dédiée. Le moins cher qui suffit répond en premier ;
frontiergarde le meilleur modèle en tête. - Séparer développement et production dans
allowedModels, pas dans la documentation. Les offres gratuites conditionnées ne doivent être appelables par aucune clé client. - Tester tous les modèles après chaque déploiement avec une requête minimale par modèle et par catégorie, et vérifier la configuration avant de redémarrer : schéma JSON, variables d’environnement présentes,
baseUrlsur chaque provider.
Conclusion
Une gateway LLM open source change la nature du problème : les fournisseurs deviennent interchangeables, les coûts visibles par requête et par client, et le choix du modèle se fait dans une configuration versionnée plutôt que dans le code. Chez nous, cinq fournisseurs gratuits ou presque absorbent la majorité du trafic courant ; les modèles premium n’interviennent qu’en secours ou sur demande explicite.
La contrepartie est un composant critique de plus à exploiter, avec ses règles de failover et une version qui bouge vite. Cette démarche rejoint notre approche Cadrage → Build → Run. Pour les questions de résidence des données qui précèdent ce choix, voir LLM d’entreprise sur Azure et RGPD ; pour le choix des modèles Anthropic, adopter Claude en entreprise.
Sources consultées
- agentgateway, documentation et code source v1.6.0 : https://agentgateway.dev/docs/standalone/latest/ et https://github.com/agentgateway/agentgateway
- Groq, modèles et tarifs : https://console.groq.com/docs/models
- Google AI Studio, clés API : https://aistudio.google.com/apikey
- NVIDIA NIM, FAQ du Developer Program : https://docs.api.nvidia.com/nim/docs/product
- OpenRouter, limites des modèles gratuits : https://openrouter.ai/docs/api/reference/limits
- Cloudflare Workers AI, API compatible OpenAI : https://developers.cloudflare.com/workers-ai/configuration/open-ai-compatibility/
- Anthropic, tarifs Claude : https://www.anthropic.com/pricing